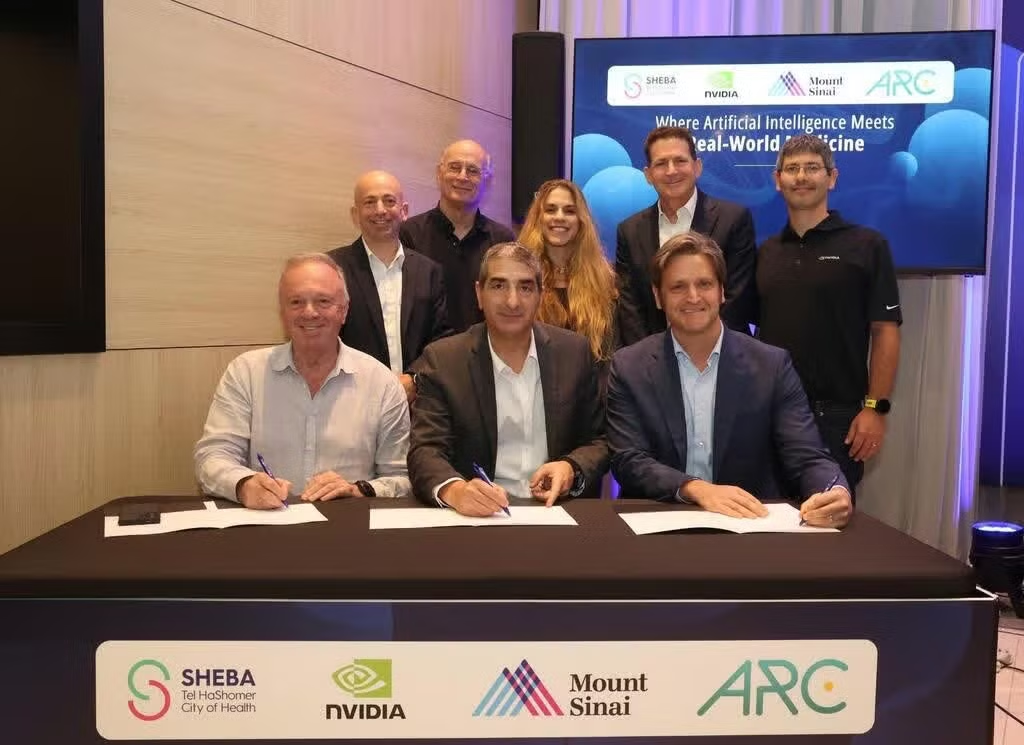
Một dự án hợp tác giữa Trung tâm Y tế Sheba của Israel, Trường Y Icahn thuộc hệ thống Mount Sinai (Mỹ) và Tập đoàn NVIDIA đang tìm cách sử dụng trí tuệ nhân tạo (AI) để giải mã những quy luật ẩn trong bộ gene, qua đó mở ra hướng đi mới cho y học chính xác.
Dự án do ARC, bộ phận đổi mới sáng tạo của Trung tâm Y tế Sheba, phối hợp với Trường Y Icahn thuộc Mount Sinai ở New York và NVIDIA triển khai. Trong khuôn khổ chương trình hợp tác kéo dài 3 năm, với tổng vốn đầu tư lên tới hàng chục triệu USD, các bên đang phát triển một Mô hình Nền tảng Bộ gene (Genomic Foundation Model - gFM).
Mục tiêu của mô hình là sử dụng AI để phát hiện các quy luật trong trình tự ADN, từ đó liên hệ những biến đổi gene với các cơ chế sinh học, bệnh tật và khả năng đáp ứng điều trị của bệnh nhân.
Theo các nhà nghiên cứu, chưa đến 2% bộ gene người trực tiếp mã hóa protein. Phần lớn còn lại là các vùng không mã hóa, trong đó có những cơ chế điều hòa quyết định thời điểm gene được kích hoạt, mức độ biểu hiện và loại tế bào mà gene hoạt động. Nhiều vùng trong số này đã được nghiên cứu, song chức năng và ý nghĩa y học của chúng vẫn chưa được hiểu đầy đủ.
Đây cũng có thể là nơi chứa những manh mối giúp giải thích nguyên nhân gây bệnh, sự khác biệt giữa các cá thể, cũng như lý do một phương pháp điều trị có hiệu quả đối với người này nhưng lại không hiệu quả với người khác.
Cách tiếp cận của dự án có điểm tương đồng với phương thức các mô hình ngôn ngữ lớn học từ văn bản. Thay vì được cung cấp khối lượng lớn từ ngữ và câu, mô hình gFM sẽ được “đào tạo” trên một lượng khổng lồ các trình tự ADN nhằm nhận diện những “quy tắc” ẩn bên trong: những trình tự nào thường xuất hiện cùng nhau, những biến thể nào có thể làm gián đoạn cơ chế điều hòa và một thay đổi gene có thể liên quan như thế nào đến hoạt động của một gene khác.
Tuy nhiên, “ngôn ngữ” của bộ gene người đặc biệt phức tạp. Một thay đổi nhỏ tại một khu vực có thể tác động đến một gene nằm cách xa vị trí đó; trong khi cùng một trình tự ADN có thể hoạt động khác nhau trong tế bào não, tế bào gan hoặc tế bào của hệ miễn dịch.
Đây là lĩnh vực mà sự hợp tác giữa ba đối tác được kỳ vọng mang lại lợi thế. Sheba và Mount Sinai cung cấp các cơ sở dữ liệu di truyền, thông tin y tế và chuyên môn lâm sàng, trong khi NVIDIA đóng góp năng lực tính toán, hạ tầng AI và kinh nghiệm xây dựng các mô hình quy mô lớn.
Mục tiêu không chỉ là giúp máy tính nhận diện những trình tự gene đáng chú ý, mà còn kết nối các dự đoán của AI với dữ liệu của bệnh nhân thực tế: ai mắc bệnh, bệnh biểu hiện như thế nào và người bệnh phản ứng ra sao với phương pháp điều trị.
Trong giai đoạn đầu, dự án sẽ tập trung vào lĩnh vực sức khỏe tâm thần và các rối loạn tâm thần-thần kinh, nơi yếu tố di truyền đặc biệt phức tạp. Chẳng hạn, đối với bệnh tâm thần phân liệt, thông thường không tồn tại một đột biến gene duy nhất có thể giải thích tình trạng bệnh. Thay vào đó, nguy cơ mắc bệnh có liên quan đến sự kết hợp của nhiều biến thể trên toàn bộ hệ gene, trong đó mỗi biến thể chỉ đóng góp một phần nhỏ.
Một mô hình có khả năng đồng thời phân tích hàng nghìn khu vực trong bộ gene và phát hiện mối liên hệ giữa chúng có thể giúp các nhà nghiên cứu xác định những biến thể thực sự có ý nghĩa, đồng thời chỉ ra các con đường sinh học cần được nghiên cứu sâu hơn.
Mục tiêu của dự án rất tham vọng. Các nhà nghiên cứu không đặt mục tiêu trong vòng 3 năm xây dựng một “từ điển” giải thích từng ký tự trong 98% bộ gene không trực tiếp mã hóa protein. Thay vào đó, họ muốn tìm kiếm những quy luật và mối liên hệ trong “kho dữ liệu” khổng lồ này mà các công cụ hiện nay khó nhận diện.
Nếu AI có thể thành công trong việc liên kết các biến thể gene với cơ chế điều hòa, các con đường sinh học và bệnh tật, các nhà khoa học có thể tiếp cận những khu vực của bộ gene mà ý nghĩa y học đến nay vẫn chưa được hiểu đầy đủ.