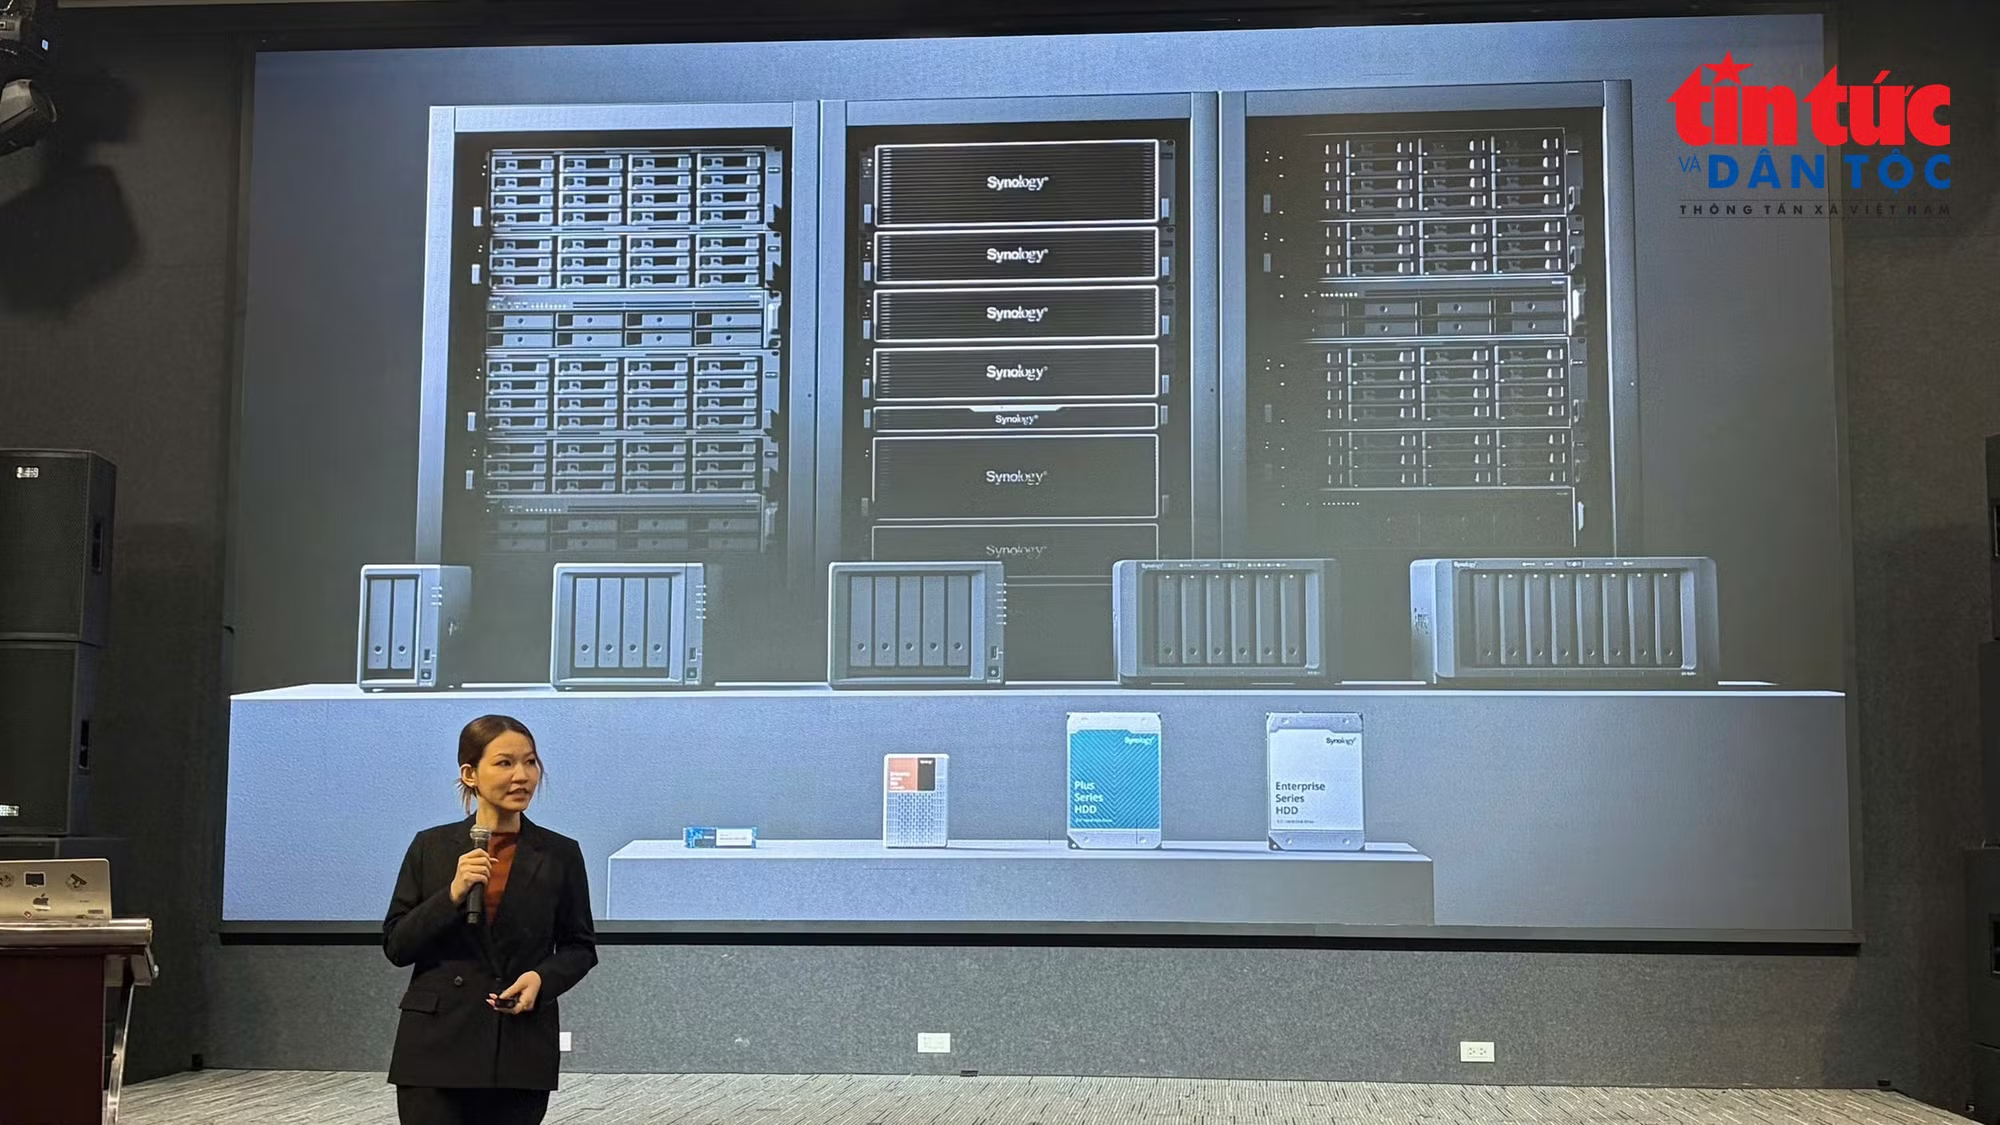
Sáng 15/10, tại TP Hồ Chí Minh, tập đoàn công nghệ Synology công bố kết quả khảo sát về hạ tầng dữ liệu và mức độ sẵn sàng ứng dụng trí tuệ nhân tạo (AI) của doanh nghiệp trong khuôn khổ sự kiện Synology Press Day 2026. Tại đây, các diễn giả tập trung phân tích những thách thức về bảo mật khi triển khai AI, từ kiểm soát dữ liệu đến phòng, chống tấn công mạng và phục hồi hoạt động sau sự cố.
Theo khảo sát, 97,6% người tham gia tại Việt Nam cho biết doanh nghiệp của họ đã triển khai công cụ bảo vệ dữ liệu. Tuy nhiên, chỉ 19,1% rất tự tin có thể nhanh chóng phục hồi sau tấn công bằng mã độc tống tiền, đồng thời bảo vệ được dữ liệu sao lưu. Khoảng cách này cho thấy, việc trang bị công cụ chưa đi cùng sự tin tưởng vào khả năng khôi phục khi sự cố xảy ra.
“Khi doanh nghiệp mở rộng hạ tầng dữ liệu, họ cũng cần có sự tin tưởng rằng các dịch vụ thiết yếu có thể được phục hồi khi xảy ra gián đoạn”, ông Henry Nguyễn, Quản lý Kinh doanh Synology Việt Nam, cho biết.
Trao đổi tại sự kiện, bà Jola Lê, Giám đốc Quốc gia Synology tại Việt Nam, lưu ý các cuộc tấn công mạng có thể nhắm đến nhiều lĩnh vực, từ y tế đến sản xuất. Với nhà máy, mã độc tống tiền có thể ảnh hưởng đến tiến độ và quy trình vận hành, kéo dài gián đoạn hoạt động.
Theo bà Jola Lê, doanh nghiệp cần tách môi trường sao lưu khỏi hệ thống đang vận hành. Nếu đặt cả hai trong cùng một môi trường, cuộc tấn công có thể ảnh hưởng đồng thời đến dữ liệu làm việc và bản sao dùng để khôi phục.
Đại diện Synology khuyến nghị kết hợp bản sao lưu được bảo vệ khỏi chỉnh sửa, xóa trái phép với cơ chế cách ly phù hợp. Doanh nghiệp cũng cần kiểm tra bản sao, quét mã độc và diễn tập phục hồi định kỳ, thay vì đợi đến khi bị tấn công mới xác định dữ liệu có thể khôi phục hay không.
Áp lực bảo vệ còn đến từ chính quá trình mở rộng ứng dụng AI. Ông Antoine Yang, Quản lý Synology khu vực Đông Nam Á, cho rằng doanh nghiệp phải tính đến cả nguy cơ tấn công từ bên ngoài và sai sót của AI trong quy trình nội bộ. Khi công cụ AI được phép thực hiện tác vụ với tốc độ cao, một lỗi xử lý cũng có thể ảnh hưởng đến dữ liệu đang phục vụ sản xuất, kinh doanh.
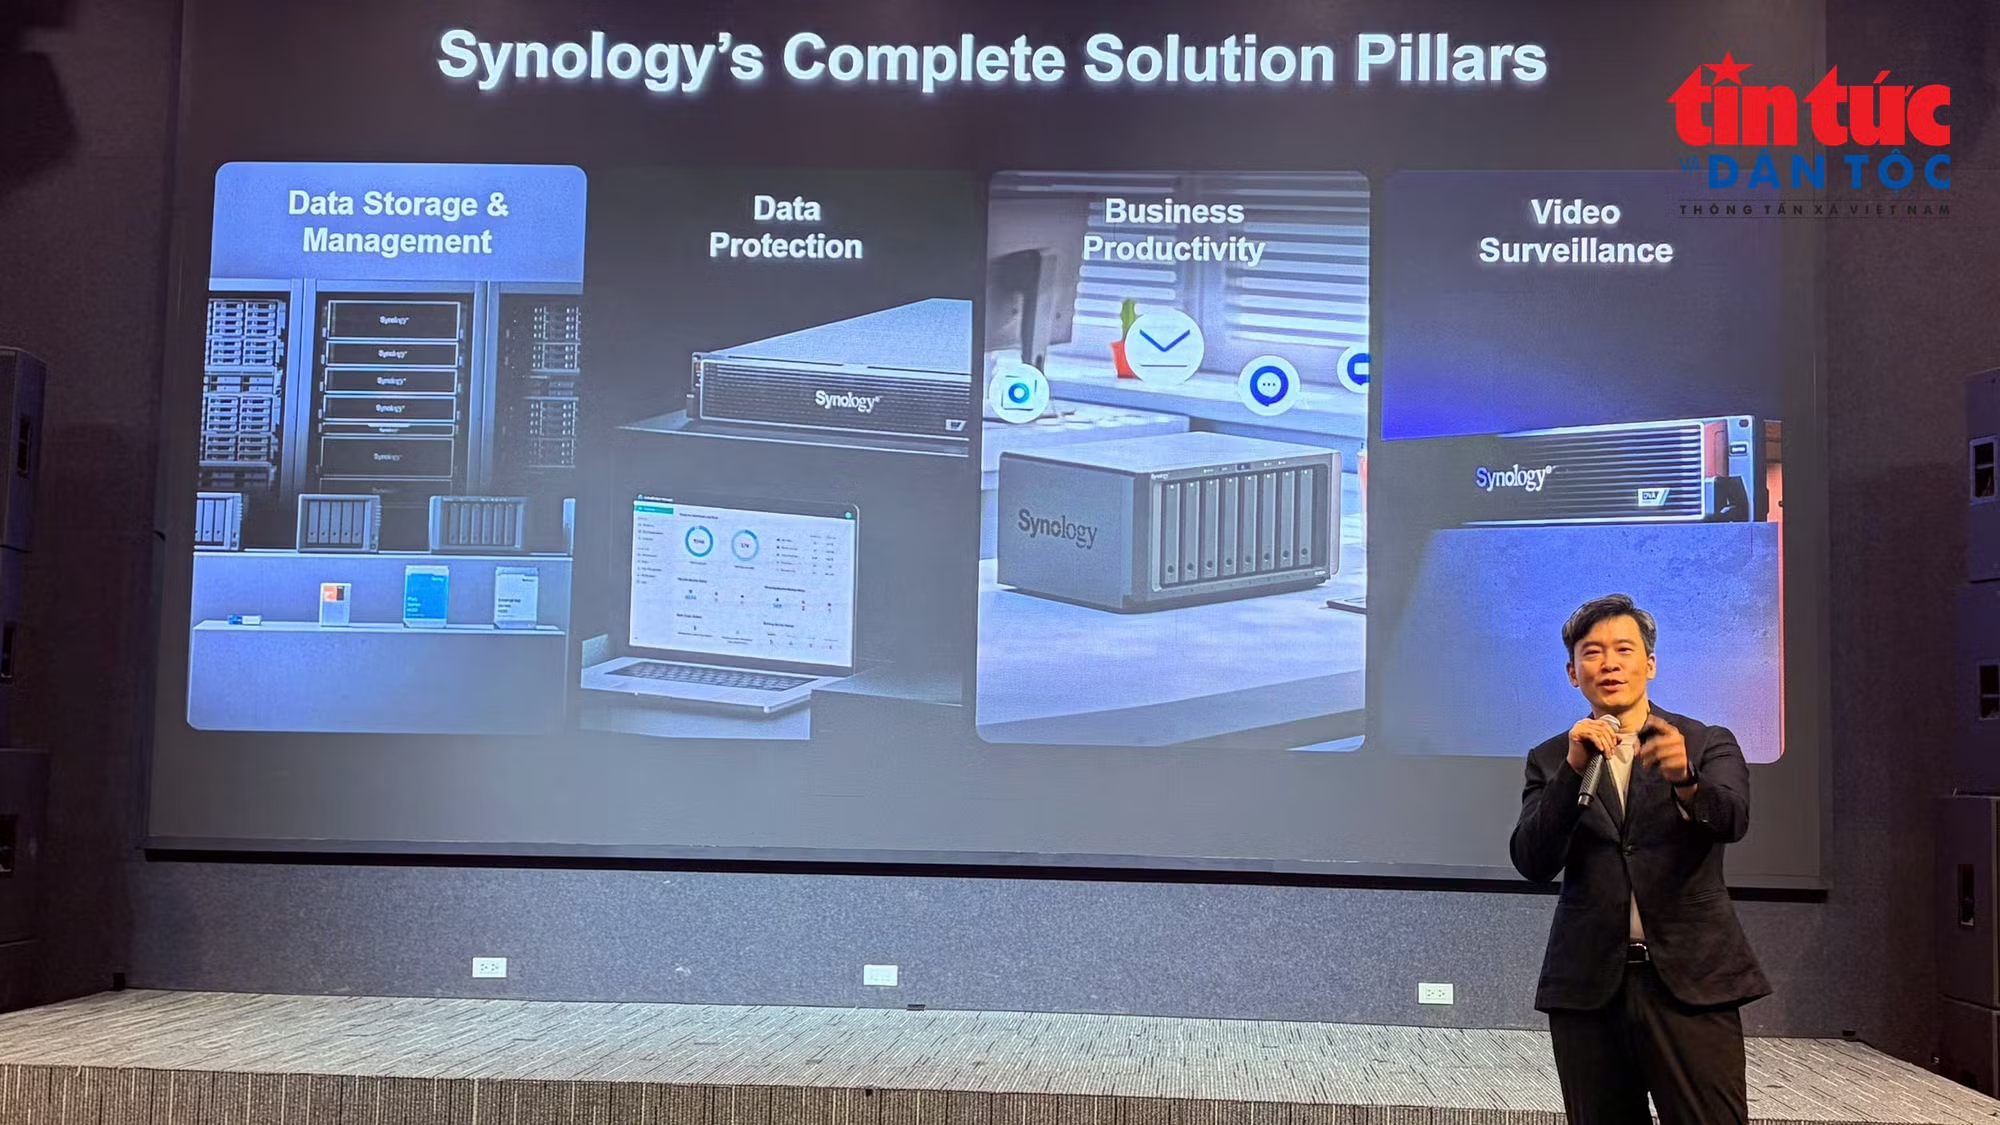
Để kiểm soát những rủi ro này, doanh nghiệp trước hết cần biết dữ liệu đang nằm ở đâu, ai được tiếp cận và thông tin nào được phép đưa vào ứng dụng AI. Theo ông Yang, dữ liệu phân tán trên máy tính cá nhân, dịch vụ đám mây, thư điện tử và ứng dụng nhắn tin đang gây khó khăn cho cả quản lý lẫn khai thác.
Ông dẫn ví dụ một doanh nghiệp có văn phòng tại TP Hồ Chí Minh, bộ phận kinh doanh ở Hà Nội và nhà máy tại Đà Nẵng. Đơn hàng nằm trong thư điện tử, báo cáo tồn kho thuộc hệ thống nhà máy, còn thông tin giao hàng trao đổi qua Zalo. Khi các nguồn chưa được kết nối, AI khó tiếp cận đầy đủ thông tin để đưa ra câu trả lời chính xác.
Bên cạnh tình trạng phân tán, tài liệu quét, hình ảnh, video và nội dung trao đổi hằng ngày cũng chứa nhiều thông tin có giá trị nhưng khó tìm kiếm, tổng hợp bằng công cụ thông thường.
Theo khảo sát, 56,7% người tham gia tại Việt Nam xem bảo mật và quyền riêng tư dữ liệu là thách thức khi ứng dụng AI, cao nhất trong các mối quan tâm được lựa chọn. Chất lượng, khả năng tiếp cận dữ liệu và chi phí triển khai đứng ngay sau đó.
Yêu cầu giữ quyền kiểm soát thông tin cũng tác động đến lựa chọn đầu tư. Khoảng 75% người tham gia ưu tiên hạ tầng tại chỗ hoặc mô hình kết hợp giữa hệ thống nội bộ và điện toán đám mây; 71,3% coi tăng cường bảo mật dữ liệu là một trong những ưu tiên hàng đầu khi nâng cấp hạ tầng.
Bà Jola Lê khuyến nghị doanh nghiệp nên xác định nhu cầu cụ thể, kiểm soát dữ liệu nhân viên sử dụng với AI, sau đó mở rộng theo hiệu quả thực tế. Doanh nghiệp đồng thời phải quản lý cẩn thận khóa khôi phục và bản sao lưu, bởi khi mất khóa hoặc thiếu bản sao phù hợp, việc lấy lại dữ liệu có thể gặp khó khăn.